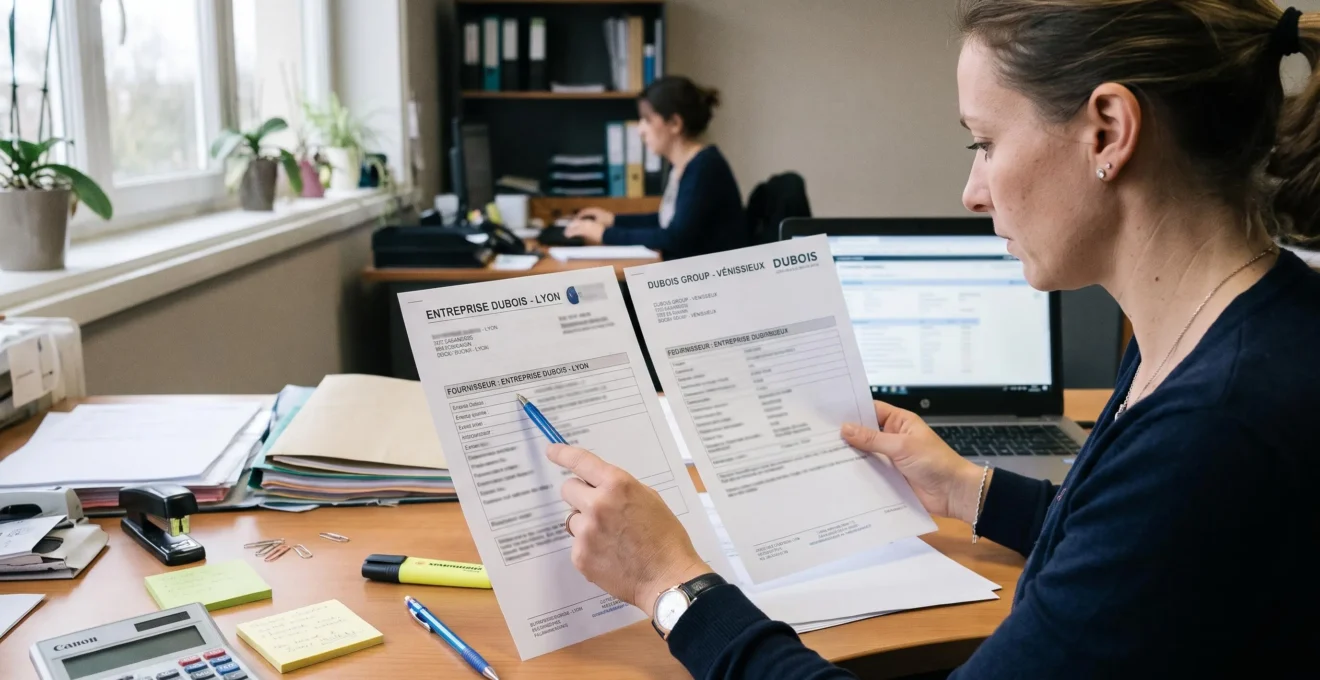
Des chiffres contradictoires dans les tableaux de bord ne signalent pas nécessairement un problème de calcul. Ils peuvent révéler une difficulté plus profonde : les données utilisées par les différents services ne sont pas suffisamment fiables, homogènes ou actualisées. Dans une PME, une même entreprise peut ainsi apparaître plusieurs fois dans le fichier fournisseurs, les informations de règlement peuvent diverger entre achats et comptabilité et les indicateurs financiers peuvent reposer sur des extractions anciennes.
Pour fiabiliser le pilotage, il faut agir sur toute la chaîne de production de l’information : identification des entités, contrôles à la saisie, responsabilités de correction, actualisation des données et traçabilité des changements. L’objectif n’est pas de multiplier les contrôles administratifs ni d’imposer immédiatement un nouvel outil. Il consiste à définir des règles métier compréhensibles, à les appliquer au bon moment et à identifier les personnes qui en garantissent le respect.
Une PME peut commencer avec quelques référentiels critiques, notamment les clients et les fournisseurs, avant d’étendre progressivement cette démarche aux autres données nécessaires à son activité.
Les trois principes pour fiabiliser les données professionnelles
- Identifier les doublons à partir de clés fiables, notamment le numéro SIREN pour les unités légales françaises, et distinguer les entités juridiques des groupes économiques.
- Intégrer des contrôles de complétude, de format et de cohérence directement dans les processus de saisie, en définissant les responsabilités de chaque service.
- Tracer les modifications sensibles, vérifier la fraîcheur des reportings et désigner des responsables de la qualité des données.
- Pourquoi un même fournisseur apparaît-il sous plusieurs identités dans les fichiers ?
- Comment contrôler les champs obligatoires avant l’enregistrement d’une donnée métier ?
- Qui doit corriger les données fournisseurs entre achats et comptabilité ?
- Les risques des indicateurs construits avec des extractions non actualisées
- Comment documenter les modifications sensibles dans un référentiel professionnel ?
- Pourquoi des nomenclatures différentes compliquent-elles le rapprochement des fichiers ?
- Data owner ou data steward : qui doit valider les règles de qualité ?
- Comment mettre en place une gouvernance des données d’entreprise adaptée à une PME ?
Pourquoi un même fournisseur apparaît-il sous plusieurs identités dans les fichiers ?
Un même fournisseur peut apparaître sous plusieurs identités parce que les équipes ne saisissent pas toujours les informations de la même manière et ne disposent pas nécessairement d’un identifiant commun. Une variation de raison sociale, une adresse différente ou l’utilisation d’un nom commercial peuvent suffire à créer plusieurs fiches pour une seule entité juridique. Ces doublons compliquent ensuite le suivi des achats, les paiements et l’analyse des dépenses.
Dans une PME, les causes sont souvent très concrètes. Un acheteur enregistre une entreprise sous son nom commercial, tandis qu’un comptable utilise sa dénomination juridique. Un autre collaborateur crée une nouvelle fiche en indiquant l’adresse du site de livraison plutôt que celle du siège social. Lorsque plusieurs personnes interviennent dans différents logiciels ou fichiers Excel, ces divergences s’accumulent.
La difficulté ne se limite pas à l’apparence des fiches. Une entreprise enregistrée deux fois peut sembler représenter deux fournisseurs différents. Les volumes d’achat sont alors répartis entre plusieurs identités, ce qui réduit la visibilité sur les montants réellement engagés et peut affaiblir la capacité de négociation. Des erreurs de rapprochement ou des paiements en double peuvent également apparaître lorsque les contrôles internes sont insuffisants.
En France, le numéro SIREN constitue un premier point de référence particulièrement utile. Selon l’Insee, cet identifiant comporte neuf chiffres et est attribué une seule fois à chaque unité légale. Il permet donc de distinguer les entreprises indépendamment des variations de leur dénomination ou de leur adresse. La définition officielle du numéro Siren par l’Insee précise également sa structure et son caractère unique.
Une méthode de détection efficace commence par le rapprochement des fiches utilisant le même SIREN. Les cas qui restent incertains peuvent ensuite être examinés à partir de plusieurs informations : nom de l’entreprise, adresse, coordonnées bancaires et autres éléments disponibles. Une comparaison automatisée peut signaler les ressemblances, mais les rapprochements ambigus doivent être soumis à une validation humaine.
Une précaution importante concerne les groupes de sociétés. Deux filiales appartenant au même groupe peuvent avoir des raisons sociales, des SIREN et des obligations de facturation distincts. Les fusionner automatiquement reviendrait à confondre deux unités légales. Le référentiel doit donc distinguer l’entité juridique qui facture et le groupe économique auquel elle appartient.
Pour faciliter cette distinction, il est utile de conserver des informations séparées sur l’identité légale, le nom commercial, les établissements, le groupe de rattachement et les adresses de livraison. Cette organisation permet de consolider les achats à l’échelle d’un groupe sans perdre la précision nécessaire à la gestion comptable.
La suppression des doublons ne suffit toutefois pas à garantir la qualité des informations futures. Il faut également empêcher l’enregistrement de nouvelles fiches incomplètes ou incohérentes, ce qui suppose de contrôler les données dès leur création.
Comment contrôler les champs obligatoires avant l’enregistrement d’une donnée métier ?
Les champs obligatoires doivent être contrôlés au moment de la saisie, en combinant trois vérifications complémentaires : la présence de l’information, le respect de son format et sa cohérence avec les autres données. Un formulaire qui impose simplement de remplir toutes les cases ne garantit donc pas qu’une fiche fournisseur soit réellement exploitable. La qualité dépend aussi de la validité des valeurs enregistrées.
Le contrôle de complétude constitue le premier niveau. Il vérifie qu’une information attendue n’est pas absente. Par exemple, une fiche fournisseur peut nécessiter une dénomination sociale, une adresse et un identifiant administratif. Ce contrôle évite les enregistrements manifestement incomplets, mais il ne permet pas de détecter une valeur erronée.
Le deuxième niveau concerne le format des informations. Un SIREN doit comporter neuf chiffres, un IBAN doit respecter une structure définie et un code postal doit correspondre au format attendu. Un champ contenant neuf caractères ne constitue cependant pas automatiquement un SIREN valide : il faut également contrôler sa validité.
Le troisième niveau porte sur la cohérence métier. Il s’agit de vérifier que les informations fonctionnent ensemble. Une adresse et un code postal doivent être compatibles, une condition de règlement doit correspondre aux règles commerciales applicables et une information bancaire doit être rattachée au bon fournisseur. Ces contrôles nécessitent parfois des règles propres à l’activité de l’entreprise.
Ces vérifications doivent idéalement être intégrées directement dans les formulaires des outils métier, notamment les ERP, CRM et logiciels comptables. Un contrôle réalisé au moment de l’enregistrement permet de signaler immédiatement une anomalie et de demander une correction à la personne qui dispose encore de l’information d’origine. À l’inverse, une anomalie détectée plusieurs semaines plus tard nécessite souvent de rechercher le document initial et de solliciter plusieurs collaborateurs.
Il reste nécessaire de hiérarchiser les champs. Certains sont bloquants parce que leur absence rend l’enregistrement inutilisable. D’autres sont recommandés, mais peuvent être complétés ultérieurement. Cette distinction évite de transformer les formulaires en obstacles administratifs.
La CNIL rappelle, dans le cadre des données à caractère personnel, que les informations doivent être pertinentes, exactes et tenues à jour lorsque cela est nécessaire. Elle recommande également de distinguer les données obligatoires des données facultatives dans la conception des fichiers. Ces principes sont présentés dans sa fiche pratique de la CNIL sur la pertinence des données. Leur portée doit être respectée : ils concernent les données personnelles et ne constituent pas un référentiel technique de validation de toutes les données professionnelles.
Un autre risque mérite une attention particulière : le contournement des contrôles. Si un logiciel impose trop de champs sans expliquer leur utilité, les collaborateurs peuvent saisir des valeurs fictives ou génériques pour débloquer l’enregistrement. La donnée paraît alors complète, mais elle est fausse. Il est donc préférable de rendre les contrôles proportionnés aux besoins opérationnels et de permettre un traitement explicite des informations réellement indisponibles.
Les cinq actions pour sécuriser la saisie des données
- Identifier les champs indispensables pour chaque type de fiche : produire une liste validée des champs bloquants.
- Définir les formats attendus : rédiger une fiche de règles précisant les formats du SIREN, de l’IBAN et du code postal.
- Décrire les contrôles de cohérence métier : établir une matrice associant les champs qui doivent être compatibles.
- Intégrer les contrôles dans les formulaires : disposer d’un formulaire testé avec des exemples de saisies valides et invalides.
- Vérifier les contournements après déploiement : produire un relevé des valeurs génériques, champs incomplets et anomalies détectées.
Une saisie correctement contrôlée réduit les anomalies, mais certaines corrections nécessitent des connaissances spécifiques. La question suivante consiste donc à déterminer quel service doit pouvoir modifier les informations fournisseurs et selon quelles règles.
Qui doit corriger les données fournisseurs entre achats et comptabilité ?
La correction des données fournisseurs doit revenir au service qui détient l’information métier concernée, avec un contrôle complémentaire lorsque la modification engage un risque financier ou administratif. Les achats connaissent les conditions commerciales et les interlocuteurs, tandis que la comptabilité maîtrise les informations nécessaires aux règlements et aux rapprochements. Une organisation efficace associe ces compétences plutôt que de confier toutes les corrections à un seul service.
Dans de nombreuses PME, les achats créent les fiches fournisseurs parce qu’ils négocient les contrats et entretiennent la relation commerciale. Ils peuvent donc renseigner la raison sociale, les contacts, les conditions contractuelles ou les informations relatives aux prestations. Pourtant, les conséquences d’une erreur se manifestent souvent en comptabilité : facture impossible à rapprocher, paiement bloqué ou coordonnées bancaires incorrectes.
Cette séparation peut générer des tensions. Le service comptable constate une anomalie mais ne dispose pas des droits nécessaires pour la corriger. Les achats, de leur côté, ne mesurent pas toujours l’impact d’une modification sur les règlements. La situation devient particulièrement problématique lorsque les collaborateurs échangent des demandes de correction par courriel sans circuit de validation formalisé.
La solution consiste à définir un périmètre de responsabilité par catégorie de données. Les achats valident les informations commerciales et contractuelles. La comptabilité valide les données de règlement, les modalités de paiement et les informations nécessaires à la facturation. Les données juridiques peuvent nécessiter une vérification à partir de documents officiels ou de justificatifs adaptés.
Cette organisation doit être complétée par un processus spécifique pour les modifications sensibles. Le changement d’un IBAN, par exemple, ne doit pas être traité comme une simple correction de coordonnées. Une demande reçue par courriel peut résulter d’une usurpation d’identité ou d’un détournement de correspondance.
Cybermalveillance.gouv.fr décrit précisément le mécanisme de fraude au faux RIB : un fraudeur usurpe l’identité d’un créancier pour détourner un virement vers un compte bancaire qu’il contrôle. Le dispositif recommande de contacter directement le créancier au moyen de son numéro de téléphone habituel afin de confirmer les nouvelles coordonnées. Cette précaution figure dans sa fiche de prévention de Cybermalveillance.gouv.fr sur la fraude au faux RIB.
Pour une PME, il est pertinent de prévoir une validation indépendante avant toute prise en compte d’un changement bancaire. La personne qui reçoit la demande ne doit pas être seule à décider de sa validité. Une confirmation par un canal de contact déjà connu, puis une validation interne par une personne habilitée, renforcent le contrôle. Cette double validation constitue une mesure organisationnelle recommandée ici, et non une obligation explicitement prescrite par la fiche institutionnelle citée.
La correction centralisée chez un seul collaborateur est rarement une solution durable. Elle crée un goulot d’étranglement et éloigne la décision de la personne qui connaît réellement le fournisseur. La correction à la source, accompagnée d’un contrôle adapté par le service concerné, offre généralement un meilleur équilibre entre réactivité et sécurité.
Une fois les responsabilités définies, il reste à garantir que les informations corrigées sont effectivement celles utilisées dans les décisions de gestion. La fraîcheur des extractions et des tableaux de bord constitue alors un autre point de vigilance.
Les risques des indicateurs construits avec des extractions non actualisées
Un indicateur construit à partir d’une extraction ancienne peut présenter une situation financière ou opérationnelle qui n’existe plus au moment où la décision est prise. Le problème est particulièrement important lorsque le tableau de bord semble fiable, mais ne précise ni sa date d’extraction ni le périmètre des données utilisées. La fraîcheur de l’information doit donc être considérée comme une caractéristique essentielle de tout reporting professionnel.
Dans une PME, les extractions Excel sont souvent utilisées pour consolider des informations provenant de plusieurs logiciels. Un responsable financier peut, par exemple, construire un suivi de trésorerie à partir d’un export comptable réalisé plusieurs semaines auparavant. Entre-temps, des factures ont été réglées, des encaissements reçus et de nouveaux engagements enregistrés.
Le tableau de bord peut alors afficher un encours fournisseur supérieur à la réalité ou sous-estimer certaines dépenses récentes. Le problème ne vient pas nécessairement du calcul, mais du décalage entre les données utilisées et la situation réelle.
Ce décalage peut entraîner un effet en cascade. Un indicateur erroné est présenté en réunion, puis utilisé comme référence par les responsables. Les décisions prises sur cette base peuvent entraîner des arbitrages budgétaires, des reports d’investissement ou des engagements commerciaux. Lorsque l’information est finalement corrigée, il devient nécessaire de réexaminer des décisions déjà prises.
La confiance dans les tableaux de bord peut alors se dégrader. Les responsables commencent à multiplier les vérifications manuelles et à produire leurs propres fichiers de référence. Chaque service dispose progressivement de ses propres chiffres, ce qui complique encore davantage les arbitrages transverses.
Une première mesure consiste à faire figurer systématiquement trois informations sur les reportings :
- La date d’extraction : elle permet de connaître l’ancienneté des données utilisées.
- La source : elle identifie le logiciel, le fichier ou le référentiel d’origine.
- Le périmètre : il précise les établissements, périodes, catégories ou entités inclus dans l’indicateur.
Il faut également adapter la fréquence d’actualisation à la nature des informations. Un suivi des prix de marché, des stocks en mouvement ou des encours clients en recouvrement n’a pas les mêmes besoins qu’un indicateur annuel de structure des dépenses. Une actualisation quotidienne peut être utile pour certains indicateurs opérationnels, tandis qu’une fréquence moins élevée peut convenir à des données plus stables.
La règle consiste donc à définir une périodicité adaptée à chaque indicateur, plutôt qu’à imposer un calendrier unique à l’ensemble des reportings. Une donnée actualisée trop rarement perd en pertinence, mais une actualisation excessive peut également mobiliser des ressources sans améliorer réellement la décision.
Il est utile de définir un responsable de chaque indicateur, chargé de vérifier la cohérence de sa source et de signaler les éventuels décalages. Les destinataires doivent également savoir si un chiffre est provisoire, consolidé ou définitif. Cette distinction évite de présenter une estimation comme une valeur arrêtée.
La fraîcheur des données permet de mieux interpréter les chiffres, mais elle ne suffit pas à expliquer les changements intervenus dans les référentiels. Pour comprendre pourquoi une information a évolué, l’entreprise doit également conserver un historique des modifications sensibles.
Comment documenter les modifications sensibles dans un référentiel professionnel ?
Les modifications sensibles doivent être documentées dans un historique qui indique l’auteur du changement, sa date, le champ concerné, l’ancienne valeur, la nouvelle valeur et le motif de la modification. Lorsqu’un justificatif existe, il doit également être associé à l’opération. Cette traçabilité permet de reconstituer les événements en cas d’erreur, de litige ou de suspicion de fraude.
Toutes les modifications n’appellent pas nécessairement le même niveau de contrôle. Une correction orthographique dans un nom de contact présente un enjeu différent du remplacement d’un IBAN ou d’une modification de raison sociale. Le niveau de journalisation doit donc être proportionné à la sensibilité de l’information.
Dans un référentiel fournisseurs, les modifications qui méritent une attention particulière comprennent notamment :
- Les coordonnées bancaires et les informations relatives aux bénéficiaires des paiements.
- Les conditions de règlement et les modalités contractuelles.
- Les informations juridiques d’identification de l’entreprise.
- Le rattachement à une entité ou à un groupe économique.
- Les informations qui déterminent les circuits d’approbation ou les règles de facturation.
La journalisation doit permettre de retrouver facilement le contexte d’une opération. Pour chaque modification, le registre peut contenir l’identité du collaborateur, la date et l’heure, le nom du champ, l’ancienne valeur, la nouvelle valeur, le motif et la référence du document justificatif. Les droits d’accès doivent être adaptés à la sensibilité des informations conservées.
Une PME n’a pas nécessairement besoin d’investir immédiatement dans un outil spécialisé. Un registre structuré ou une fonctionnalité d’historisation intégrée au logiciel métier peut constituer un point de départ, à condition que les modifications soient réellement enregistrées et que l’historique ne puisse pas être modifié librement sans contrôle.
Cette traçabilité présente un intérêt particulier lorsqu’un problème est découvert plusieurs semaines après une modification. Sans historique, les équipes doivent reconstituer les faits à partir des courriels, des documents conservés et des souvenirs des personnes concernées. Avec un journal structuré, elles peuvent retrouver la chronologie des événements et identifier les changements intervenus.
Il faut néanmoins éviter la documentation purement décorative. Un registre qui accumule les informations sans être consulté ne constitue pas un véritable mécanisme de contrôle. Une revue périodique des modifications sensibles, par exemple lors d’un contrôle mensuel, permet de repérer les changements inhabituels, les justificatifs manquants ou les validations incomplètes.
Cette revue doit rester proportionnée aux risques. Les changements bancaires, les modifications d’identité juridique et les évolutions des conditions de paiement peuvent faire l’objet d’un examen prioritaire. Les corrections moins sensibles peuvent être suivies selon un niveau de contrôle adapté.
La traçabilité explique comment une information a évolué, mais un autre problème peut empêcher les rapprochements entre services : l’utilisation de catégories et de nomenclatures différentes pour décrire les mêmes activités.
Pourquoi des nomenclatures différentes compliquent-elles le rapprochement des fichiers ?
Des nomenclatures différentes compliquent le rapprochement des fichiers parce que chaque service peut décrire une même réalité avec ses propres catégories, codes et règles de classement. Les données restent compréhensibles à l’intérieur de chaque département, mais deviennent difficiles à consolider dès qu’une analyse implique plusieurs fonctions. Une nomenclature commune permet de rapprocher les informations sans imposer nécessairement un remplacement immédiat de tous les outils.
Dans une PME, le service commercial peut classer les clients par secteur d’activité, la comptabilité par famille de produits et les achats par site de consommation. Chaque classement répond à un besoin métier légitime. Pourtant, lorsque la direction souhaite connaître la rentabilité par client, elle doit rapprocher des fichiers qui ne reposent pas sur les mêmes dimensions.
La difficulté augmente lorsque les libellés semblent identiques, mais ne recouvrent pas les mêmes périmètres. Une catégorie intitulée « France » peut, par exemple, inclure les départements et régions d’outre-mer dans un fichier et les exclure dans un autre. Le rapprochement des deux fichiers donne alors une impression de cohérence qui ne correspond pas à la réalité des données.
Les conséquences dépassent les difficultés techniques. Sans correspondance entre les référentiels, les responsables ne peuvent pas analyser facilement la rentabilité d’un client en tenant compte des achats, des ventes et des coûts associés. Les équipes doivent multiplier les retraitements manuels, ce qui augmente les risques d’erreurs et ralentit la production des indicateurs.
La première étape consiste à identifier les dimensions réellement partagées par l’entreprise : clients, fournisseurs, produits, sites, établissements ou familles d’activités. Ces dimensions servent de base à la construction d’une nomenclature de référence.
Il n’est pas nécessaire de remplacer immédiatement les catégories existantes dans tous les logiciels. Une PME peut créer des tables de correspondance permettant d’associer les codes locaux aux catégories communes. Le service commercial conserve ainsi son classement opérationnel, tandis que la direction peut exploiter une classification consolidée pour ses analyses.
Une table de correspondance doit préciser le code d’origine, le libellé d’origine, la catégorie de référence et la règle de conversion. Lorsque plusieurs catégories locales correspondent à une même catégorie centrale, cette relation doit être documentée. Les cas sans équivalence évidente doivent être arbitrés plutôt que rapprochés arbitrairement.
La documentation des définitions est aussi importante que celle des intitulés. Il faut préciser ce que chaque catégorie inclut et exclut, son périmètre géographique ou organisationnel et les règles utilisées pour affecter une donnée. Sans cette précision, les équipes peuvent continuer à produire des chiffres contradictoires malgré l’utilisation d’un vocabulaire commun.
La démarche doit rester progressive. Les dimensions les plus utiles au pilotage peuvent être alignées en premier, puis les correspondances étendues à mesure que les besoins de consolidation évoluent. Cette méthode limite les changements imposés aux équipes et facilite l’adoption des nouvelles règles.
Ces règles communes nécessitent enfin un responsable capable de les arbitrer et un interlocuteur opérationnel chargé de les appliquer. La distinction entre data owner et data steward permet de structurer cette organisation sans créer une administration disproportionnée.
Data owner ou data steward : qui doit valider les règles de qualité ?
Le data owner décide des règles de qualité applicables à un domaine de données et arbitre les choix métier, tandis que le data steward veille à leur application quotidienne et signale les anomalies. Dans une PME, ces fonctions peuvent être exercées par des collaborateurs qui conservent leurs responsabilités habituelles. L’essentiel est de distinguer clairement le pouvoir de décision de la responsabilité opérationnelle.
Le data owner est responsable de la définition des règles. Il décide notamment des informations indispensables dans une fiche fournisseur, des critères d’identification d’un doublon et des conditions dans lesquelles une modification sensible doit être validée. Il doit également arbitrer les situations dans lesquelles plusieurs services défendent des besoins différents.
Cette responsabilité peut être confiée au dirigeant, au directeur financier ou à un responsable de fonction, selon la nature des données et l’organisation de l’entreprise. Le choix doit tenir compte de la capacité réelle de la personne à prendre des décisions métier et à faire appliquer les règles dans les services concernés.
Le data steward intervient davantage dans l’exécution. Il vérifie la qualité des informations, identifie les anomalies récurrentes, accompagne les utilisateurs et fait remonter les difficultés rencontrées dans l’application des règles. Il peut, par exemple, constater que les contrôles imposés lors de la création des fournisseurs ne correspondent pas aux documents réellement disponibles.
Il ne doit pas décider seul de modifier une règle structurante. Si une information obligatoire devient difficile à obtenir, le steward doit signaler le problème au data owner, qui peut arbitrer une évolution du processus. Cette séparation évite que les règles changent progressivement au gré des habitudes de saisie.
La confusion entre les deux fonctions est particulièrement risquée dans les PME. Lorsque personne n’est officiellement désigné, les règles sont souvent définies par défaut par le collaborateur qui configure le logiciel ou par les usages historiques. Deux services peuvent alors appliquer des critères différents sans qu’aucun arbitrage n’ait été rendu.
La norme internationale ISO 8000-150:2022 traite précisément des rôles et responsabilités nécessaires à la gestion de la qualité des données. Son périmètre comprend notamment la mise en œuvre des responsabilités et les preuves documentaires associées. La norme ISO 8000-150 sur les rôles et responsabilités en qualité des données constitue une référence organisationnelle utile, sans imposer un modèle unique à toutes les PME.
Une formalisation courte suffit souvent pour commencer. Elle peut préciser le domaine de données concerné, le nom du data owner, le nom du data steward, les règles applicables, les modalités de validation et la fréquence de révision. Le document doit être compris par les équipes opérationnelles, et non uniquement par la direction ou le service informatique.
La validation doit également être réexaminée lorsque l’entreprise ajoute un logiciel, ouvre un établissement ou modifie un processus métier. Une règle adaptée à une organisation de petite taille peut devenir insuffisante lorsque plusieurs équipes interviennent désormais sur le même référentiel.
La désignation de ces deux rôles constitue une étape importante, mais elle doit s’inscrire dans une organisation plus globale. Pour qu’elle soit durable, la gouvernance des données doit être adaptée à la taille de la PME et intégrée aux pratiques quotidiennes.
À retenir avant de structurer la gouvernance
- Commencer par les référentiels qui ont le plus d’impact sur les décisions financières et opérationnelles, notamment les clients et fournisseurs.
- Attribuer chaque règle à un responsable métier et identifier les collaborateurs chargés de son application quotidienne.
- Intégrer les contrôles, la traçabilité et les revues de qualité dans les processus existants plutôt que de créer une organisation administrative parallèle.
Comment mettre en place une gouvernance des données d’entreprise adaptée à une PME ?
Une gouvernance des données adaptée à une PME repose sur trois décisions fondamentales : identifier les informations critiques pour le pilotage, désigner les personnes responsables de leur qualité et définir les règles de création, de modification et de contrôle. Elle ne nécessite pas obligatoirement un comité spécialisé ni un nouvel outil. Elle doit avant tout organiser les pratiques existantes et rendre les responsabilités compréhensibles.
La première difficulté consiste à vouloir traiter toutes les données simultanément. Une PME dispose généralement de nombreux fichiers, applications et référentiels, mais tous n’ont pas le même impact sur les décisions. Il est donc préférable de commencer par un périmètre restreint, notamment les référentiels clients et fournisseurs, avant d’étendre progressivement les règles aux produits, aux établissements et aux indicateurs de gestion.
Pour choisir les premières données à fiabiliser, plusieurs critères peuvent être examinés :
- Leur importance pour les décisions financières et commerciales.
- La fréquence à laquelle elles sont utilisées par plusieurs services.
- Les conséquences opérationnelles d’une erreur ou d’une information manquante.
- Le niveau actuel de duplication, d’incohérence ou d’obsolescence.
- La possibilité d’identifier un responsable métier capable de les contrôler.
La deuxième étape consiste à formaliser les responsabilités. Chaque domaine de données doit avoir un data owner chargé de valider les règles et un interlocuteur opérationnel chargé de suivre leur application. Les équipes doivent savoir à qui signaler une anomalie et quel circuit utiliser pour demander une modification.
La troisième étape porte sur les règles de gestion. Un document court peut définir les champs obligatoires, les formats attendus, les contrôles de cohérence, les conditions de rapprochement des doublons et les validations nécessaires pour les changements sensibles. Il doit également préciser les informations qui doivent être conservées dans l’historique.
La quatrième étape consiste à intégrer ces règles dans les outils et les routines existantes. Les formulaires de saisie, les processus de validation, les tableaux de bord et les revues comptables peuvent devenir autant de points de contrôle. L’objectif est d’éviter que la qualité des données repose uniquement sur la vigilance individuelle des collaborateurs.
La gouvernance doit enfin être suivie dans le temps. Quelques indicateurs simples permettent de vérifier son efficacité : nombre de doublons détectés, proportion de fiches incomplètes, anomalies de format, modifications sensibles sans justificatif et reportings produits avec une date d’extraction clairement identifiée. Ces mesures doivent être interprétées selon le périmètre concerné et leur évolution, sans créer de seuils arbitraires.
La norme ISO 8000-150:2022 apporte un cadre de référence pour formaliser les rôles, responsabilités et éléments documentaires liés à la qualité des données. Pour une PME, l’intérêt est de s’inspirer de cette logique organisationnelle sans reproduire une structure disproportionnée par rapport à ses moyens.
Le facteur humain reste déterminant. Les règles doivent être expliquées aux équipes, intégrées à la formation des nouveaux arrivants et rappelées lors des changements de processus. Les collaborateurs doivent également pouvoir signaler une règle inapplicable ou une difficulté récurrente sans être incités à la contourner silencieusement.
Le dirigeant joue un rôle important dans cette démarche. Son implication permet de légitimer les arbitrages entre services, de donner du poids aux responsables de données et de maintenir les efforts au-delà de la phase initiale de mise en conformité des référentiels.
Pour un responsable de PME confronté à des chiffres contradictoires, la prochaine étape consiste à choisir un premier référentiel critique, à identifier son responsable et à documenter les anomalies les plus fréquentes. Cette approche progressive permet de construire une information plus fiable sans engager immédiatement une transformation lourde de l’ensemble du système d’information.
Comment savoir si les données de mon entreprise sont fiables ?
Il faut examiner leur exactitude, leur complétude, leur cohérence et leur fraîcheur. Une première vérification consiste à rechercher les doublons dans les fichiers clients et fournisseurs, à contrôler les champs essentiels et à comparer les informations entre les services. La présence d’une date d’extraction, d’une source et d’un périmètre sur les tableaux de bord permet également d’évaluer la fiabilité des indicateurs.
Faut-il acheter un logiciel spécialisé pour fiabiliser les données d’une PME ?
Non, pas nécessairement. Une PME peut commencer avec les fonctionnalités de contrôle et d’historisation de ses logiciels existants, complétées par des référentiels structurés et des règles métier documentées. Un outil spécialisé peut devenir pertinent lorsque les volumes, les applications ou les besoins de rapprochement rendent les contrôles manuels insuffisants. Le choix doit découler des problèmes réellement rencontrés.
Quelle différence entre un référentiel de données et une base de données classique ?
Une base de données stocke des informations selon une organisation technique. Un référentiel constitue une source de référence partagée pour un domaine métier, comme les clients, les fournisseurs ou les produits. Il associe généralement des identifiants, des définitions et des règles de gestion afin que les différents services utilisent des informations cohérentes.
Qui doit être responsable de la qualité des données dans une petite entreprise ?
La responsabilité doit être répartie selon les domaines métier. Le dirigeant ou un responsable de fonction peut assurer le rôle de data owner pour arbitrer les règles, tandis qu’un collaborateur opérationnel peut exercer celui de data steward pour surveiller leur application. Les achats, la comptabilité et les autres services concernés conservent la responsabilité des informations relevant de leur expertise.
À quelle fréquence faut-il contrôler et actualiser les données professionnelles ?
La fréquence dépend de la nature et de l’utilisation des données. Les informations volatiles, comme les stocks ou certains encours financiers, nécessitent des actualisations plus rapprochées que des données structurelles. Les modifications sensibles doivent être contrôlées au moment où elles interviennent, tandis que les référentiels et les reportings peuvent faire l’objet de revues périodiques adaptées à leur usage.